





Snowflakeは、米国時間11月3日に開催した「Snowflake Expedition 2026」で、「Autonomous Data Engineering」とリアルタイムアナリティクスの新機能を発表した。Autonomous Data Engineeringは、データパイプラインの構築・運用・修復に伴う定型作業をAIエージェントが処理する仕組みで、本番環境への適用はエンジニアが判断する。リアルタイムアナリティクスは、データの取り込みから活用までを、ガバナンスを適用した単一のプラットフォームでつなぐ。
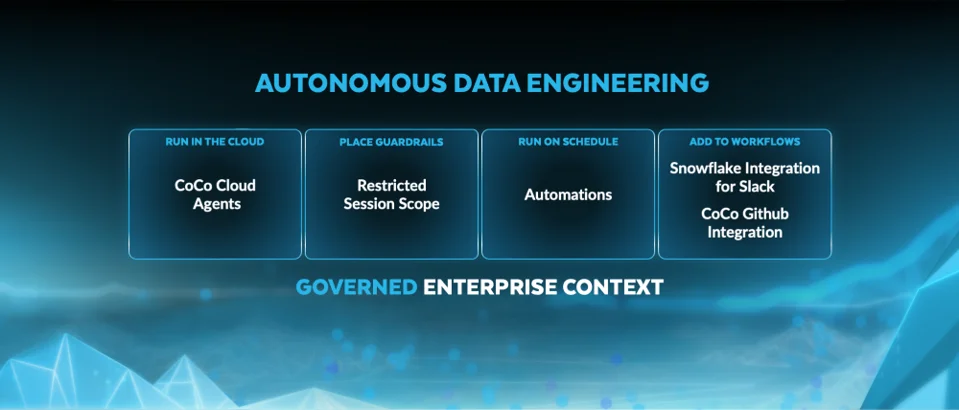
「CoCo Cloud Agents」は、Snowflake CoCoをエンジニアのローカルPCではなく、Snowflakeのマネージドクラウド環境で実行する機能。セッションごとに専用のセキュアなコンテナが割り当てられ、エンジニアがログオフした後も処理は継続する。「CoCo Restricted Session Scope」を使えば、エージェントの操作権限を細かく制限できる。「CoCo Automations」では、パイプラインの正常性確認などのタスクを自然言語で定義し、定期実行させられる。問題を検知するとCoCoが原因をたどって修正案を提示し、エンジニアが確認したうえで本番環境に反映する。Slack連携やGitHub連携にも対応する。また「Snowflake Pipeline Builder」では、ビジュアルエディター上のドラッグ&ドロップ操作でパイプラインを構築できる。
リアルタイムアナリティクスでは、Snowpipe Streamingがデータ量に応じて自動的にスケールする「Elastic Channels」に対応した。Kafka利用者向けの「Snowflake Datastream」は、接続先をSnowflakeに変更するだけで利用でき、ブローカーやコネクタの管理が不要になる。さらに、ストリーミング中のデータを標準SQLで変換する「Streaming Transformations」と、1秒未満のレイテンシーでアプリケーションやAIエージェントに回答を返す「Interactive Analytics」を提供する。取り込み性能は毎秒最大20GBで、データが利用可能になるまでの時間は中央値で3秒としている。
Apache Spark向けには、Snowpark ConnectにDataFrame Writer V2 APIと柔軟なパーティショニングへの対応を追加した。これにより、Icebergテーブルに書き込む既存のSparkパイプラインを、コードの変更を抑えてSnowflakeへ移行できる。
【関連記事】
・Snowflake、Google Cloud東京リージョンでのサポートを2026年度第4四半期に開始
・Snowflake、動的モデルルーティングでAIコスト最適化とモデル選択肢を拡充
・Snowflakeが示す、企業のAIエージェント活用に不可欠なデータ基盤とは?
この記事は参考になりましたか?
- この記事の著者
-

CodeZine編集部(コードジンヘンシュウブ)
CodeZineは、株式会社翔泳社が運営する開発者のための情報メディアです。日々の開発に取り組むエンジニアやテクノロジーを学びたい方に向けて、プログラミングやAI活用、開発ツール、エンジニアの学びとキャリアに関する記事をお届けしています。
※プロフィールは、執筆時点、または直近の記事の寄稿時点での内容です

この記事は参考になりましたか?
この記事をシェア
